
¿Qué es el tracking server-side?
El tracking server-side traslada el procesamiento y el envío a proveedores a infraestructura que tú controlas, normalmente un contenedor de Google Tag Manager server-side (sGTM). En una configuración típica, la recogida sigue empezando con una petición del dispositivo del comprador; las llamadas directas del backend al proveedor son otra fuente de eventos.
En lugar de que el navegador hable directamente con Google, Meta y una docena de endpoints más, envía una sola petición a tu endpoint, y tu servidor decide qué reenviar, a quién y con qué datos.
Merece la pena tomarse al pie de la letra el planteamiento del propio Google: el etiquetado server-side mide la actividad «dondequiera que ocurra», con beneficios declarados de rendimiento de página, controles de privacidad y calidad de datos. Es una lista honesta. Fíjate en lo que no está en ella: no promete recuperar conversiones perdidas ni vencer al consentimiento. El valor es real pero acotado, y la mayor parte de la decepción viene de esperar la versión sin límites.
Este artículo es la versión honesta: qué recupera, qué no tocará y en qué se diferencian de verdad las opciones de arquitectura.
¿Qué recupera de verdad el tracking server-side?
El server-side te da control sobre los eventos recibidos y su envío posterior. Un endpoint first-party puede reducir algunas pérdidas del navegador, pero la duración de las cookies y la entrega de peticiones siguen dependiendo de las protecciones del navegador, los bloqueadores y el consentimiento.
1. Comportamiento de las cookies bajo ITP. Safari restringe las cookies fijadas por scripts y también limita las establecidas mediante CNAME que encubren servicios de terceros. Fijar una cookie en una respuesta HTTP desde tu propio subdominio no elimina automáticamente esos límites. Comprueba el alojamiento real y el comportamiento del navegador en lugar de prometer un reconocimiento más duradero de visitantes recurrentes.
2. Pérdida por bloqueadores de anuncios y scripts. Un endpoint first-party cambia el destino de la petición, pero un sGTM típico sigue recibiéndola desde el dispositivo del visitante. Los bloqueadores pueden impedir la carga del script o la petición al endpoint antes de que llegue nada al servidor. Cualquier reducción de pérdidas depende de la implementación y debe medirse, no darse por hecha.
3. Fiabilidad de red. Los beacons del navegador son de mejor esfuerzo y mueren con la pestaña, una conexión caída o un rebote rápido. Una vez que un evento llega a tu servidor, la entrega a cada proveedor se convierte en una llamada servidor a servidor que puedes reintentar, encolar y monitorizar.
4. Enriquecimiento y validación antes de reenviar. El servidor puede aplicar hash a los PII correctamente, adjuntar datos de primera parte (el valor del pedido desde tu backend, un id de cliente, un email con hash), eliminar campos que un proveedor no debería recibir y validar el payload antes de enviarlo. Aquí es donde mejora de verdad la calidad de emparejamiento: alimentar un conjunto limpio y con hash de em/fbp/fbc hacia la Meta Conversions API que el navegador nunca tuvo.
Ninguna de estas es un porcentaje que pueda prometer. Son mecanismos. Cuánto recuperas depende de qué parte de tu tráfico es Safari, con cuánta agresividad bloquea tu audiencia y cuánta pérdida tiene tu configuración actual. Cualquiera que cite una cifra fija de recuperación sin ver tu tráfico está adivinando.
¿Cuándo no ayuda el tracking server-side?
Esta es la sección que los proveedores se saltan. El server-side no hace nada por ninguno de los siguientes casos, y comprarlo para arreglarlos es tirar el dinero:
- Negativas de consentimiento. Si un comprador rechaza las cookies de analítica o de publicidad, un contenedor de servidor bien construido debe seguir respetándolo. El server-side reubica dónde se ejecutan las etiquetas; no fabrica permiso. Usarlo para sortear el consentimiento es un problema de cumplimiento, no una funcionalidad. (Esto cubre la implementación técnica, no asesoramiento legal.)
- Diferencias entre modelos de atribución. GA4, Meta, Google Ads y Shopify cuentan las conversiones con modelos, ventanas y definiciones distintos. Nunca coincidirán a la perfección, y el server-side no cambia las reglas de recuento de ninguna plataforma; consulta por qué los ingresos de GA4 no coinciden con Shopify.
- Un dataLayer roto. Si los eventos, valores u objetos ecommerce que empuja tu sitio son erróneos, el servidor reenvía fielmente datos erróneos. Si entra basura, sale basura, ahora con mejores garantías de entrega. Arregla primero la recogida.
- Las reglas de recuento y la lógica de deduplicación de las plataformas. El server-side puede causar doble recuento si reenvías un evento que el navegador también envía sin un identificador compartido. No reconcilia los dos de forma automática; esa es una decisión de diseño que tienes que tomar tú.
- Una mala estrategia de medición. Definiciones de conversión equivocadas, eventos clave ausentes o una taxonomía de canales que no refleja tu marketing: el server-side lo hereda todo.
La regla general: el server-side arregla el transporte y el enriquecimiento. Si tu problema es de permiso, definición o lógica, es la herramienta equivocada.
Comparativa de opciones de arquitectura
No existe una única «configuración server-side». Hay cuatro formas comunes, que intercambian las mismas tres monedas: dinero, control y mantenimiento.
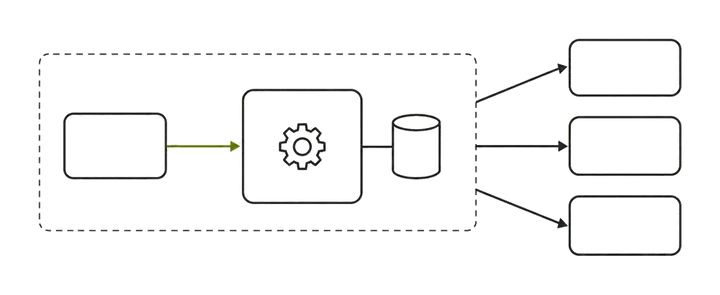
Tabla comparativa — desplázate horizontalmente para ver todas las columnas
| Opción | Qué es | Factores de coste | Control | Mantenimiento |
|---|---|---|---|---|
| sGTM alojado en Stape | Alojamiento gestionado para un contenedor sGTM | Plan mensual según volumen de peticiones; complementos para mejoras | Alto dentro de GTM; el proveedor es dueño de la infraestructura | Bajo: Stape se encarga del alojamiento, el escalado y las actualizaciones |
| GCP autoalojado | Tu propio sGTM en Cloud Run / App Engine detrás de un balanceador de carga | Cómputo y egreso según uso; tiempo de ingeniería | Máximo: control total de infraestructura y datos | Alto: tú eres dueño del escalado, el uptime, los parches y los logs |
| APIs de conversión directas | Código que envía directamente al Measurement Protocol de GA4, Meta CAPI, Google Ads, sin contenedor | Tiempo de desarrollo; sin cuota de contenedor | Total a nivel de código; sin interfaz de GTM | Medio: código a medida que debes mantener por cada proveedor |
| Plataforma gestionada | Un servicio todo en uno que ejecuta la recogida y el reenvío por ti | Suscripción; mínima ingeniería | Mínimo: configuras, no construyes | Mínimo: el proveedor es dueño del pipeline |
Divulgación: soy el fundador de Fixel Pixel, que ocupa esa última fila, un pipeline server-side gestionado para Shopify. Lo incluyo porque omitirlo sería deshonesto, no porque gane por defecto. Encaja con un comerciante que quiere los beneficios de transporte sin contratar un equipo de operaciones ni cuidar un contenedor de GTM, y es la elección equivocada para un equipo que quiere ser dueño de su infraestructura GCP o para un desarrollador que prefiere escribir llamadas directas a las APIs. Un buen consultor debería ser capaz de quitarte de su propio producto: si quieres el máximo control, autoaloja; si tienes una sola conversión y un desarrollador, las APIs directas son lo más ligero; si quieres que te lo gestionen, una opción gestionada —la mía o el sGTM alojado de Stape— se gana su cuota. La respuesta correcta es función de tus restricciones, y la comparación honesta está en la página del servicio de tracking server-side.
Recogida en subdominio de primera parte, restauración de cookies y diseño de la deduplicación
Un endpoint first-party te da control sobre la ruta de recogida; no esquiva por defecto el consentimiento, los bloqueadores ni las protecciones de privacidad del navegador. Safari también limita las cookies establecidas mediante CNAME que encubren servicios de terceros. Configura y comprueba la ruta en lugar de tratar un CNAME como prueba de recuperación.
- Apunta un subdominio al contenedor mediante CNAME, por ejemplo
data.yourstore.com. Stape proporciona un host de destino; en GCP mapeas un dominio personalizado al balanceador de carga. Este subdominio debe estar en tu propio dominio raíz: un dominio de proveedor frustra todo el propósito. - Carga el contenedor web / gtag desde ese subdominio, para que la petición que hace el navegador sea a
data.yourstore.com, que es de primera parte para el comprador. - Deja que el servidor fije la cookie de identificador en la respuesta HTTP (
Set-Cookie,HttpOnly) desde ese dominio de primera parte. Comprueba el ámbito de la cookie, sus requisitos de acceso y su duración observada. Las cookies fijadas por el servidor no están exentas de las protecciones de privacidad del navegador, incluidos los límites de Safari sobre CNAME que encubren servicios de terceros. - Diseña la deduplicación a propósito. Si mantienes el Pixel del navegador (normalmente deberías), genera un
event_idpor conversión y envía el valor idéntico por el navegador y por el servidor para que las plataformas fundan la pareja. Equivocarse aquí es una forma habitual de que el server-side empeore tus datos; la mecánica completa está en Deduplicación en Meta CAPI: cómo funciona realmente event_id.
El subdominio y la configuración de cookies afectan a la recogida, pero el enriquecimiento, el reenvío y la observabilidad siguen siendo útiles independientemente de la duración de las cookies. Comprueba cada tramo de la ruta en lugar de equiparar un dominio propio con protección frente a las pérdidas.
¿Cómo sabes que el contenedor de servidor está fallando en silencio?
Un contenedor de servidor puede devolver 200 OK mientras no reenvía nada útil: la etiqueta del navegador parece correcta, el contenedor parece sano y un proveedor rechaza cada payload por un desajuste de esquema que nunca ves. El fallo silencioso es el modo de fallo por defecto.
Qué vigilar:
- Códigos y cuerpos de respuesta de los proveedores. Registra lo que devuelven realmente GA4, Meta y Google Ads, no solo que tu contenedor haya respondido. Un
2xxde tu contenedor no dice nada sobre si Meta aceptó el evento. - Ratios de volumen. Sigue los eventos de servidor frente a los de navegador frente a los pedidos reales de Shopify en una ventana móvil. Una divergencia repentina —el recuento de servidor desplomándose mientras los pedidos se mantienen— es tu aviso más temprano.
- La propia superficie de depuración del proveedor. GA4 DebugView y Meta Test Events muestran si los eventos llegan y se validan en tiempo real.
- Los logs de peticiones del contenedor. Stape expone logs de peticiones y monitorización; el GCP autoalojado requiere que montes tú mismo Cloud Logging y las alertas. En cualquier caso, un contenedor sin monitorizar es una caja negra.
- Alertas ante caídas. Una alerta de umbral sobre el ratio servidor-pedidos convierte una caída silenciosa de varias semanas en una corrección el mismo día.
Si no puedes responder a «¿cómo me enteraría de que esto se ha roto mañana?», todavía no tienes una configuración server-side en la que confiar.
Tabla de decisión: ¿deberías invertir en server-side?
Tabla comparativa — desplázate horizontalmente para ver todas las columnas
| Invierte en server-side si… | Sáltalo (por ahora) si… |
|---|---|
| Una gran parte de tu tráfico es Safari/iOS y ves decaimiento en la vida de las cookies | Tu problema es que las plataformas no coinciden: eso es atribución, no transporte |
| La pérdida por bloqueadores de anuncios es importante para tu audiencia | La mayor parte de tu pérdida son negativas de consentimiento |
| Necesitas enriquecer los eventos con datos del backend (valor del pedido, email con hash) antes de enviarlos | Tu dataLayer está roto o incompleto: arregla primero la recogida |
| Ya ejecutas Pixel + CAPI y quieres una tubería duradera y monitorizada | Quieres que «recupere conversiones» sin ningún otro cambio |
| Puedes comprometerte a monitorizar (o pagar a un proveedor gestionado para que lo haga) | Nadie se hará cargo de la observabilidad, así que fallará en silencio |
El server-side premia a los comerciantes con un problema real de transporte y la disciplina de monitorizarlo, y castiga a quienes lo compran como capa mágica de recuperación.
Cómo verifico esto en implementaciones reales
Divulgación de nuevo: llevo un producto server-side, así que someto mis propias instalaciones a la prueba de los recuentos, no al discurso.
- Ejecutar navegador y servidor en paralelo. Mantengo ambos activos con un
event_idcompartido y confirmo que las plataformas deduplican la pareja en lugar de duplicar el recuento; el beneficio de transporte no vale nada si infla las cifras. - Conciliar contra los pedidos. Para una ventana fija comparo el recuento de Purchase reenviado desde el servidor con la exportación real de pedidos de Shopify, esperando convergencia dentro de una pequeña varianza estructural; una brecha persistente en cualquier dirección es lo que hay que perseguir: la misma conciliación de pedidos que aplico en cada auditoría.
- Leer las respuestas de los proveedores, no el estado del contenedor. Registro lo que devuelven GA4 y Meta y confirmo que los eventos se validan, no solo que mi endpoint respondió.
- Comprobar el comportamiento de las cookies. Compruebo la duración observada del identificador en Safari con el dominio y el alojamiento reales, incluidas las restricciones aplicables a CNAME que encubren terceros, y documento los límites en lugar de asumir que persiste.
Ejecutar en paralelo y conciliar es lo que separa una configuración server-side que funciona de otra que simplemente existe.
Modos de fallo habituales
- Contenedor alcanzado a través de un host de proveedor, así que las cookies siguen siendo de tercera parte y ITP aún las trunca: el coste de mantenimiento sin ninguno de los beneficios.
- Doble recuento por reenviar un evento que el navegador también envía sin un
event_idcompartido. - Rechazo silencioso aguas abajo:
200del contenedor, payloads rechazados por el proveedor, nadie registrándolo. - Señal de consentimiento descartada en el servidor, así que los usuarios que rechazaron siguen siendo rastreados: un fallo de cumplimiento, no una optimización.
- Enriquecimiento obsoleto: aplicar hash al campo equivocado o adjuntar un valor de pedido que no coincide con el esquema esperado por el proveedor.
- Sin monitorización, así que cualquiera de los casos anteriores se prolonga semanas antes de que alguien note las cifras.
Limitaciones
El server-side es una capa de transporte y enriquecimiento, y su techo lo fija lo que llega hasta él.
No puede ver eventos que el navegador nunca generó, ni volver a recabar consentimiento de un usuario que lo rechazó, ni hacer que coincidan dos plataformas con modelos de atribución distintos. Añade infraestructura que tienes que ejecutar y monitorizar y, hecho con descuido, puede degradar la calidad de los datos por doble recuento.
Tampoco es un atajo de privacidad: las mismas obligaciones de consentimiento y minimización de datos se aplican, solo que ejecutadas en tu servidor. Usado para lo que es —una tubería fiable y enriquecible— es una de las mejoras de mayor impacto disponibles. Usado como milagro de recuperación, decepciona siempre.
Alternativas
Si tu pérdida se concentra en un solo punto, una corrección más acotada puede superar a un contenedor completo. Para una única conversión de alto valor, una llamada directa a la API de conversión (Measurement Protocol de GA4, Meta CAPI o Google Ads) es más ligera que levantar sGTM.
Si el problema real es que las plataformas no coinciden, la respuesta es el trabajo de conciliación y atribución, no una infraestructura nueva. Si tu dataLayer es el eslabón débil, arregla primero la recogida. Y si la restricción es el ancho de banda operativo, un pipeline gestionado compra los beneficios de transporte sin la carga de operaciones. Ajusta la herramienta a la pérdida real: el server-side es potente cuando la pérdida está en la capa de transporte, y excesivo cuando está en cualquier otro sitio.
